L’échec du mot-clé en 2026 : Pourquoi votre moteur de recherche actuel vous fait perdre des ventes
Un client m’a récemment posé une question concrète : pourquoi, alors que son catalogue regorge de trenchs élégants et de robes en soie traitée, sa boutique PrestaShop ne renvoyait aucun résultat pour la requête “tenue pour un mariage pluvieux” ?
C’est un constat récurrent. Le moteur de recherche natif de PrestaShop, basé sur une indexation SQL classique (requêtes LIKE ou Full-Text), est structurellement incapable de saisir l’intention derrière les mots. Il cherche des chaînes de caractères là où l’utilisateur exprime un besoin contextuel. Si le mot “pluvieux” n’est pas explicitement présent dans la fiche produit, l’algorithme échoue et le client abandonne son panier. Ce défaut technique se traduit immédiatement par une hausse du taux de rebond.
Le problème réside dans la rigidité du schéma relationnel traditionnel. SQL traite les mots comme des jetons isolés, sans aucune notion de proximité sémantique. Aujourd’hui, les attentes des consommateurs ont évolué : habitués aux interfaces conversationnelles et aux recherches multimodales, ils ne tolèrent plus d’être confrontés à un message “0 résultat” pour une requête complexe. Pour corriger cela, il faut dépasser la base de données relationnelle pour la recherche et exploiter la puissance des espaces latents.
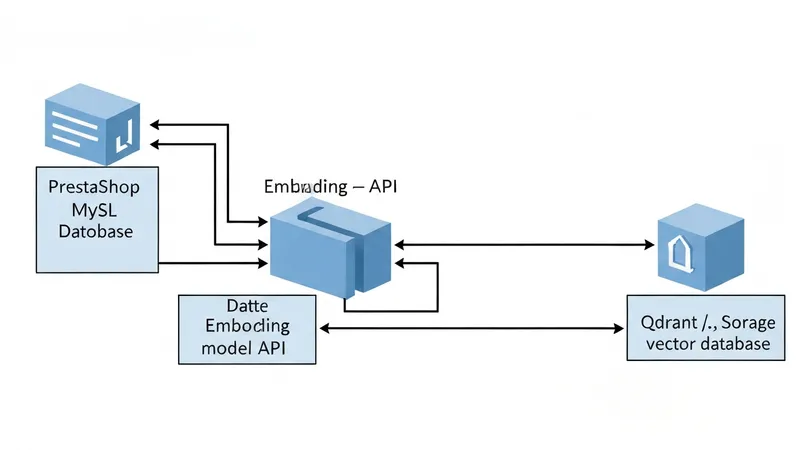
Architecture technique recherche vectorielle
La solution ne réside pas dans l’accumulation fastidieuse de synonymes dans le back-office, une méthode jamais exhaustive. La véritable rupture technologique consiste à transformer chaque produit et chaque requête en vecteurs numériques dans un espace à haute dimension. C’est ici qu’intervient la recherche sémantique : elle permet de trouver des produits dont la signification est proche de la requête, même sans mot commun. Une robe imperméable sera mathématiquement proche du concept “pluie”, permettant de sauver des ventes perdues à cause d’un archaïsme technique.
| Caractéristique | Recherche SQL Native | Recherche Vectorielle (AI) |
|---|---|---|
| Compréhension | Littérale (mots-clés) | Sémantique (intentions) |
| Tolérance aux fautes | Faible (nécessite soundex/levenshtein) | Inhérente à l’embedding |
| Performances (Gros catalogues) | Dégradées avec de nombreux JOIN | Constante via indexation HNSW |
| Complexité d’implémentation | Nulle (out-of-the-box) | Modérée (nécessite middleware) |
Ce que fait la recherche native avec une requête
PrestaShop ne se contente pas d’un LIKE brut sur chaque fiche : la recherche native s’appuie sur un index de mots construit à partir des fiches. Le principe reste le même : elle compare des mots, jamais leur sens. Il se résume à une requête de ce type :
SELECT pl.id_product, pl.name
FROM ps_product_lang pl
WHERE pl.id_lang = 1
  AND pl.id_shop = 1
  AND (pl.name LIKE '%veste%' OR pl.description_short LIKE '%veste%');
Selon la collation de vos tables, souvent insensible aux accents, « impermeable » trouve « imperméable ». En revanche, un terme absent de la fiche ne produit aucun résultat, et un motif qui commence par un joker (%veste) empêche d’utiliser un index classique. Concrètement :
- Synonymes : « anorak », « parka » et « blouson » ne se trouvent pas entre eux, sauf si vous ajoutez des règles à la main.
- Fautes de frappe : « vsete » ne trouve pas « veste », sauf avec un module de correction.
Architecture technique : Connecter PrestaShop à une base de données vectorielle
Passer à une recherche de nouvelle génération impose de repenser le flux de données. On ne peut pas demander à MySQL de gérer efficacement des vecteurs de 1536 dimensions. L’architecture préconisée repose sur un découplage clair : PrestaShop reste la source de vérité pour les données transactionnelles et le catalogue (MySQL), tandis qu’une base de données vectorielle spécialisée gère l’indexation de recherche.
Le schéma logique se décompose en trois piliers :
- Pipeline d’extraction : récupération des données textuelles structurées (nom, description, caractéristiques).
- Modèle d’embedding : transformation de ces textes en suites de nombres flottants via des modèles comme ceux d’OpenAI, de Cohere ou des modèles locaux type Mistral.
- Stockage vectoriel : intégration dans une base comme Qdrant ou Weaviate. Ces outils utilisent des algorithmes de type HNSW (Hierarchical Navigable Small World) pour garantir des recherches de similarité ultra-rapides, même sur des volumes massifs.
Cette structure distribuée offre une résilience accrue. En cas de maintenance de la base vectorielle, vous pouvez basculer sur le SQL natif. De plus, cela décharge votre serveur principal des calculs coûteux liés à la recherche. L’utilisation d’un worker asynchrone permet de synchroniser le catalogue en temps réel : dès qu’un produit est modifié dans PrestaShop, son vecteur correspondant est mis à jour automatiquement. Une architecture propre, scalable et tournée vers l’avenir.
Tutoriel : Étapes d’intégration d’une base Qdrant avec PHP 8.4+
Passons à la mise en œuvre technique. Depuis peu, PHP 8.4 offre des performances accrues pour manipuler les volumes de données JSON. Pour interfacer PrestaShop avec Qdrant, l’utilisation de Guzzle est recommandée pour gérer les appels asynchrones.
Étape 1 : Extraction et Formatage
Créez un script CLI (via Symfony Console, intégré à PrestaShop) pour parcourir le catalogue. L’objectif est de construire un “document” riche afin de donner un contexte maximal au modèle d’embedding.
// Exemple de construction du texte pour l'embedding
$productData = [
    'id' => $product->id,
    'content' => sprintf(
        "Produit: %s. Catégorie: %s. Description: %s. Attributs: %s",
        $product->name[1],
        $product->category,
        strip_tags($product->description_short[1]),
        $this->getAttributesString($product)
    )
];
Étape 2 : Génération des vecteurs et Upsert
Une fois le texte préparé, envoyez-le au modèle d’embedding pour obtenir le vecteur (array de floats), puis transmettez-le à Qdrant.
$client = new \GuzzleHttp\Client(['base_uri' => 'http://votre-qdrant-server:6333']);

$response = $client->put('/collections/products/points', [
    'json' => [
        'points' => [
            [
                'id' => (int)$product->id,
                'vector' => $vectorFromEmbeddingModel,
                'payload' => ['name' => $product->name[1], 'price' => $product->price]
            ]
        ]
    ]
]);
L’utilisation du champ ‘payload’ est ici cruciale. Cette fonctionnalité de Qdrant permet de stocker des métadonnées. Lors de la recherche, vous pouvez ainsi appliquer des filtres “hard” (ex: prix < 100€) directement sur les résultats vectoriels, combinant précision du SQL et souplesse de l’IA.
| Solution | Type | Avantage Majeur | Facilité PHP |
|---|---|---|---|
| Qdrant | Open Source / Rust | Vitesse de recherche extrême | Excellente (API REST simple) |
| Weaviate | Open Source / Go | Gestion native des modules IA | Bonne |
| Pinecone | SaaS uniquement | Zéro maintenance serveur | Moyenne (SDK spécifique) |
Le Hook Search : Remplacer la logique native sans casser le template
Évitez de modifier directement le cœur de PrestaShop. Pour une intégration pérenne, créez un module implémentant l’interface ProductSearchProviderInterface. Cela permet d’intercepter la requête avant qu’elle n’atteigne MySQL.
Dans votre classe personnalisée, capturez la chaîne saisie par l’utilisateur, transformez-la en vecteur via le même modèle utilisé lors de l’indexation, puis interrogez Qdrant pour obtenir les IDs des produits classés par score de similarité. Cette approche est la plus stable : elle préserve la logique native de pagination et de facettes tout en changeant uniquement la source des résultats.
La robustesse est non négociable. Si la base vectorielle ne répond pas instantanément, un “fallback” vers la recherche classique doit être activé pour garantir l’expérience utilisateur. Lorsque le système fonctionne, les résultats sont bluffants : une requête comme “truc pour courir sous la pluie” affichera vos meilleures vestes de trail imperméables, même si le mot “truc” est absent du catalogue. C’est là que réside la puissance de la compréhension sémantique.
Note sur la conformité : Lors de l’envoi de requêtes à des API d’embedding tierces (comme OpenAI), ne transmettez jamais de données personnelles (PII).
- Anonymisez les requêtes en supprimant noms propres ou adresses.
- Utilisez des tunnels TLS 1.3 pour tout transfert vers votre Vector DB.
- Stockez les vecteurs sans lien direct avec l’identité de l’utilisateur dans la base vectorielle.
Requêtes en langage courant : ce qui change vraiment
Les écarts apparaissent surtout quand le client formule sa recherche comme il parle. Quatre cas types :
- Vocabulaire identique à la fiche (« veste imperméable randonnée ») : les deux moteurs trouvent les mêmes produits, et la recherche native suffit.
- Vocabulaire différent : en SQL, « veste imperméable randonnée » ne trouve pas un « anorak waterproof trail », alors que le besoin est le même. La recherche vectorielle rapproche les deux textes.
- Besoin exprimé par une situation (« tenue pluie randonnée ») : le moteur vectoriel peut ramener une veste décrite comme imperméable, même sans le mot « pluie ».
- Requête hors catalogue (« perceuse sans fil » dans une boutique de vêtements) : la recherche native renvoie zéro résultat, alors que la recherche vectorielle sans seuil renvoie quand même les produits les plus proches. C’est le piège décrit plus bas.
Le gain se joue donc sur les requêtes qui ne reprennent pas les mots de la fiche. Pour une requête exacte, la recherche native fait déjà le travail.
Confidentialité et RGPD : La gestion des données de recherche
Le traitement des données est un point critique. Les autorités surveillent de près l’usage des modèles d’IA en e-commerce. Transformer une requête utilisateur en vecteur peut révéler des préférences personnelles ; ce processus doit figurer dans votre registre RGPD.
La solution la plus sûre consiste à utiliser des modèles d’embedding auto-hébergés si votre infrastructure le permet. Des bibliothèques PHP couplées à des micro-services Python (via FastAPI) permettent de générer les vecteurs en interne, garantissant que les données ne quittent pas votre périmètre. Si vous optez pour une solution Cloud, assurez-vous que vos contrats interdisent l’utilisation de vos données pour l’entraînement des modèles globaux.
Il est important de noter que le vecteur est une représentation mathématique abstraite. Bien qu’il soit illisible par un humain, il constitue une empreinte de l’intention. Sa durée de conservation doit être limitée au strict nécessaire (session de recherche ou amélioration algorithmique), conformément au principe de minimisation des données.
Optimisation et Bonnes Pratiques : Éviter l’explosion des coûts
L’implémentation de la recherche vectorielle engendre des coûts (jetons API ou ressources GPU/CPU). Pour optimiser vos dépenses, le caching est indispensable. Les requêtes fréquentes (“chaussures”, “promo”) ne doivent jamais être ré-embeddées. Un cache Redis stockant la correspondance “requête textuelle -> vecteur” réduira considérablement vos coûts opérationnels.
L’indexation doit également être asynchrone. Ne forcez pas le back-office à attendre la génération du vecteur lors de l’enregistrement d’un produit. Utilisez une file de messages (RabbitMQ ou Symfony Messenger) pour traiter ces tâches en arrière-plan. Cela garantit une fluidité totale pour les administrateurs tout en maintenant un index à jour.
Avertissement technique : La latence réseau peut ruiner l’expérience utilisateur. Si votre serveur PrestaShop est à Paris et votre Vector DB en Virginie, le temps de trajet (round-trip) rendra la recherche laborieuse. Privilégiez un hébergement dans la même zone de disponibilité ou sur le même réseau privé.
Limites à connaître
La qualité des fiches produit
Le vecteur ne résume que le texte qu’on lui fournit. Une fiche sans description, au nom générique et sans catégorie donnera un résultat médiocre, quel que soit le modèle. Soignez le nom, la catégorie et les attributs utiles (matière, usage) avant l’indexation.
Le seuil de pertinence
Sans seuil, la recherche renvoie toujours les produits les plus proches, même pour une requête sans rapport avec votre catalogue. Calibrez le score minimal sur vos requêtes réelles, et affichez un message « aucun résultat » en dessous. Un seuil trop haut écarte de bons produits ; un seuil trop bas laisse passer du bruit.
Les critères précis
Prix, taille et disponibilité ne relèvent pas de la similarité. Filtrez-les dans PrestaShop, ou via des métadonnées stockées dans Qdrant. Une valeur copiée dans Qdrant (prix, stock) doit alors être resynchronisée à chaque modification, sinon elle devient fausse.
Données personnelles dans les requêtes
Une requête peut contenir une donnée personnelle saisie par erreur : un nom, une adresse, un numéro de commande. Filtrez ce contenu avant tout envoi à un fournisseur d’embeddings, en appliquant les règles de la section sur la confidentialité ci-dessus.
L’API de recherche
L’API de Qdrant n’est pas protégée par défaut. Ne l’exposez pas publiquement, et limitez le service de recherche au réseau local ou protégez-le par un jeton.
Mesurer l’apport sur vos propres requêtes
Avant de migrer, rejouez sur les deux moteurs les recherches restées sans résultat, extraites du module de statistiques de recherche de votre boutique. Comparez les listes de résultats sur votre catalogue réel, et non sur quelques exemples choisis.
Verdict : La recherche sémantique est-elle indispensable pour votre boutique ?
Tout le monde n’a pas besoin de cette technologie. Si vous gérez une boutique de niche avec peu de références très spécifiques, le SQL natif bien configuré suffit. En revanche, pour tout catalogue important ou pour les boutiques multisectorielles, la recherche vectorielle devient le standard en 2026.
Le gain sur la conversion doit être mesuré sur vos propres requêtes, et non supposé. L’objectif n’est pas de “faire de l’IA”, mais de garantir que le client trouve ce qu’il cherche dès la première seconde. C’est un investissement direct dans l’ergonomie et la performance commerciale.
L’intégration demande une maîtrise solide de PHP, des API REST et une compréhension des concepts de machine learning. Cependant, la maturité d’outils comme Qdrant rend l’aventure bien moins complexe qu’il y a quelques années. C’est le moment idéal pour prendre une longueur d’avance sur vos concurrents encore limités par des moteurs de recherche textuels obsolètes.
Questions Fréquemment Posées
Puis-je utiliser la recherche vectorielle sur un hébergement mutualisé ?
C’est déconseillé. La recherche vectorielle nécessite soit un serveur dédié/VPS pour faire tourner une base comme Qdrant, soit l’utilisation d’une offre SaaS externe (Pinecone). Les hébergements mutualisés limitent souvent les ports et les ressources nécessaires.
Quel est le coût moyen d’un modèle d’embedding en 2026 ?
Le coût dépend du fournisseur, du volume de requêtes et de l’hébergement choisi. Via API, calculez-le à partir de la grille tarifaire du fournisseur ; en auto-hébergement, il dépend surtout de la consommation CPU et de la mémoire de votre serveur.
La recherche vectorielle fonctionne-t-elle avec toutes les langues ?
Oui, c’est l’un de ses avantages majeurs. Les modèles d’embedding “multilingues” permettent à un client de taper une requête en espagnol et de trouver des produits dont la description est en français, car le vecteur capture le concept universel de l’objet.
Faut-il réindexer le catalogue si le modèle d’embedding change ?
Oui. Des vecteurs issus de deux modèles différents ne sont pas comparables : il faut tout réindexer.
